IMDb Algo Bench
Ce que coûte vraiment un tri, sur 40 000 films.
- Type
- Algorithmique
- Cadre
- Projet universitaire, BUT 1
- Année
- 2024
- Technologies
- Java, JConsole
Une application Java en console charge une base de films IMDb, de 100 à 40 000 lignes, puis permet de les afficher, trier, filtrer, rechercher et supprimer. Chaque opération est chronométrée, pour comparer en pratique le tri sélection, le tri fusion, le tri de Java, la recherche linéaire et la recherche dichotomique.
Les mesures ont surtout montré l’effet de la structure de données. Sur une LinkedList, le tri fusion passe de 4 secondes à 124 secondes quand on multiplie les films par quatre : chaque accès par position reparcourt la liste. Collections.sort, qui copie la liste dans un tableau avant de trier, reste sous les 20 millisecondes.
J’ai complété l’analyse avec JConsole : le chargement de 40 000 films occupe environ 110 Mo, et leur simple affichage fait monter le tas à près de 600 Mo, à cause des chaînes créées puis jetées à chaque ligne.
- Tri sélection, tri fusion et Collections.sort chronométrés
- Recherche linéaire et dichotomique comparées
- Mémoire et processeur suivis avec JConsole
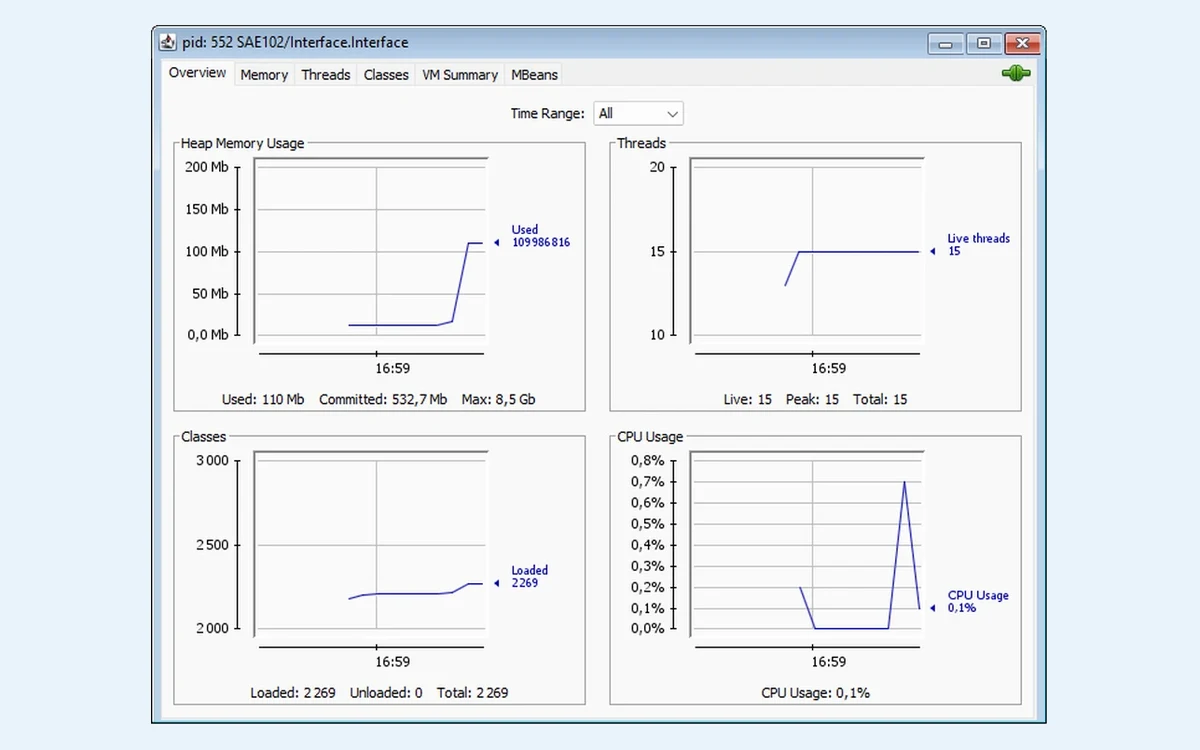
JConsole pendant le chargement des données : environ 110 Mo de mémoire
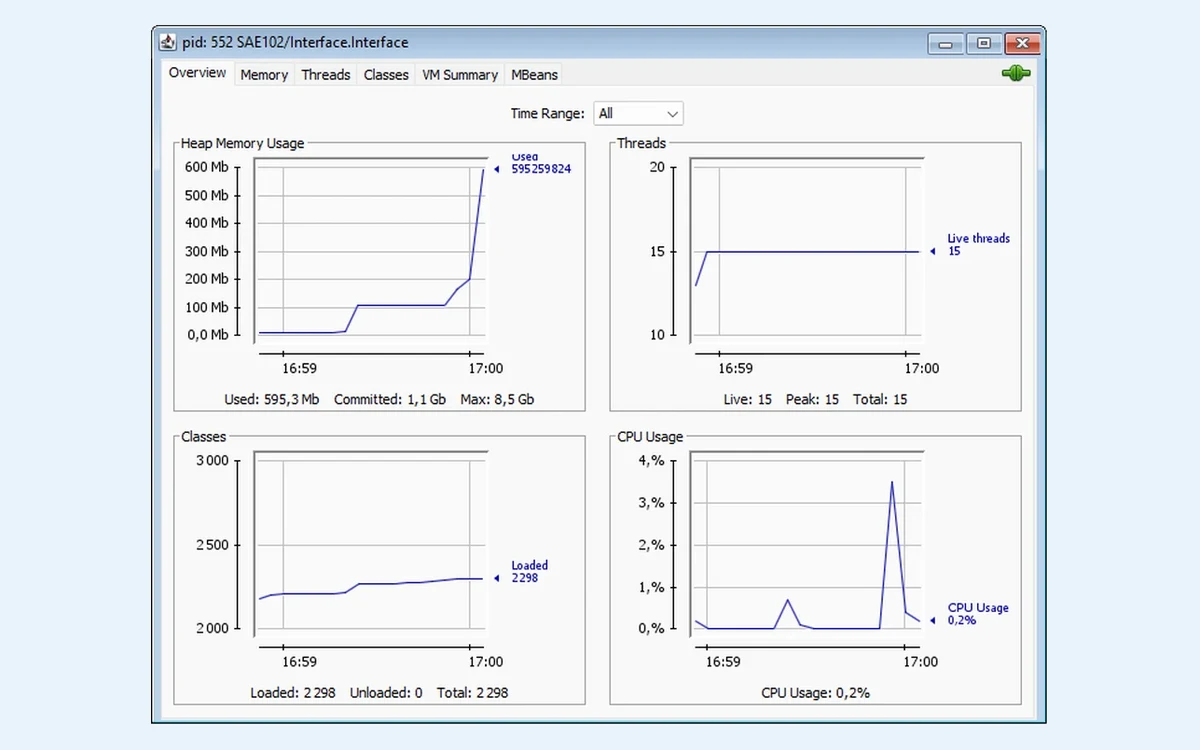
Pendant l’affichage, la mémoire monte à près de 600 Mo
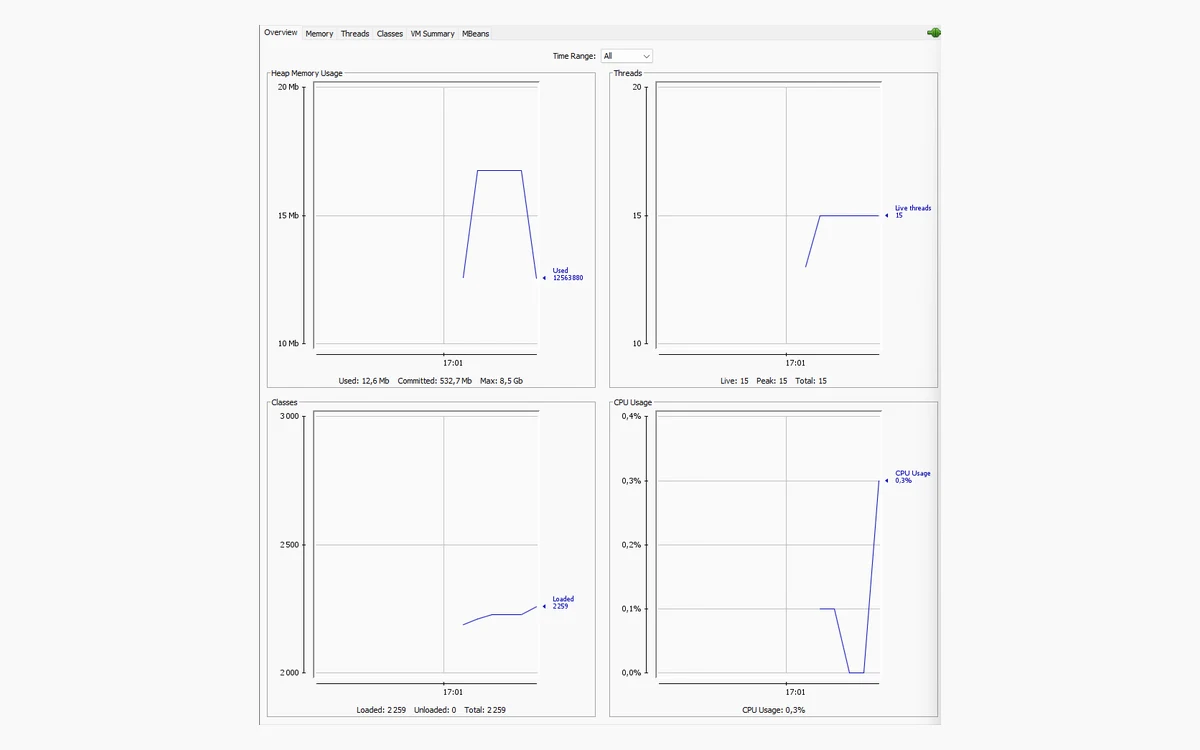
Tri sélection sur 1 000 films : la mémoire bouge à peine, tout le coût est en temps